

Ngày thứ 86: Nextdoor đang gặp khó khăn? Hay mọi thứ đã trở lại bình thường?
Ngày lễ Lao động đã kết thúc.
Hôm nay là ngày thứ 86 trong chuỗi nghiên cứu trường hợp Nextdoor của tôi, và sau khi tự hỏi hôm qua liệu Nextdoor có đang nghỉ lễ dài ngày hay không, hôm nay tôi đã kiểm tra lại.
Tôi chưa nhận được bất kỳ thông tin liên lạc nào liên quan đến hai nghiên cứu chi tiết của Insights mà tôi đã yêu cầu.
Còn NXDR thì sao?
Tính đến thời điểm viết bài này, giá đang dao động quanh mức thấp 2,20 đô la. Các nguồn tin thị trường cho thấy giá khoảng 2,24 đô la vào cuối chiều nay sau khi đóng cửa ở mức 2,24 đô la vào thứ Sáu, vì vậy con số chính xác đang thay đổi ngay lúc này.
Ít nhất thì giờ chúng ta cũng đang nói đến những khoản tiền nhỏ rồi.
Nextdoor đang gặp sự cố à?
Tôi vẫn đang cố gắng tìm ra câu trả lời cho câu hỏi đó.
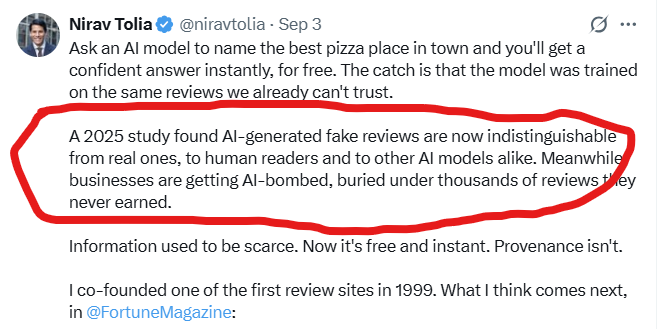
Nhưng một điều Nirav Tolia đăng trên X vào ngày 3 tháng 9 đã thu hút sự chú ý của tôi.
“Một nghiên cứu năm 2025 đã phát hiện ra rằng…”
Trong bài đăng, Nirav viết:
“Một nghiên cứu năm 2025 cho thấy các đánh giá giả mạo do AI tạo ra hiện nay không thể phân biệt được với các đánh giá thật…”
Và ngay lập tức tôi nghĩ:
Lại chuyện cũ tái diễn.
Một nghiên cứu.
Nghiên cứu nào?
Ai đã viết nó?
Nó được xuất bản ở đâu?
Phương pháp nghiên cứu là gì?
Kích thước mẫu là bao nhiêu?
Vậy chính xác thì "không thể phân biệt" có nghĩa là gì?
Điều này có lẽ quen thuộc với bất cứ ai đã theo dõi hành trình 86 ngày tìm hiểu về tính minh bạch trong nghiên cứu Nextdoor của tôi.
Điều thú vị là: Tôi đã tìm hiểu và thấy có những nghiên cứu chứng minh cho phát biểu của Nirav.
Trong một bài báo trên tạp chí Fortune được đăng cùng ngày, Nirav đã xác định cụ thể hơn đây là một nghiên cứu năm 2025 của Trường Kinh doanh Đại học Nottingham.
Các nghiên cứu được bình duyệt năm 2025 xem xét các đánh giá giả mạo do AI tạo ra, bao gồm một nghiên cứu trên Tạp chí Bán lẻ và Dịch vụ Khách hàng phân tích 714.016 đánh giá và tìm thấy những khác biệt đáng kể về ngôn ngữ giữa các đánh giá giả mạo do AI tạo ra, các đánh giá giả mạo do con người tạo ra và các đánh giá xác thực.
Vậy nên lời chỉ trích của tôi không phải là:
“Nghiên cứu đó không tồn tại.”
Câu hỏi của tôi là:
Sao không trích dẫn nguồn đó ngay trong bài đăng gốc?
Nếu bạn định sử dụng nghiên cứu để tạo dựng uy tín, hãy cung cấp cho người đọc đủ thông tin để họ tự đánh giá nghiên cứu đó.
Tên nghiên cứu. Tác giả. Ấn phẩm. Liên kết.
Bốn điều.
Xong.
Đặc biệt là khi bạn là CEO của một công ty hiện đang quảng bá ý tưởng rằng nguồn gốc xuất xứ rất quan trọng.
Điều đó gần như quá hoàn hảo.
Không có đánh giá giả mạo nào xuất hiện với ChatGPT
Một phần khác trong cuộc thảo luận này khiến tôi băn khoăn.
Trí tuệ nhân tạo không phải là thứ phát minh ra các đánh giá giả mạo.
Trí tuệ nhân tạo (AI) đã giúp sản xuất chúng nhanh hơn, rẻ hơn và dễ dàng hơn trên quy mô lớn.
Con người đã thao túng danh tiếng từ rất, rất lâu rồi.
Thực tế, lịch sử này khá thú vị.
Những năm 1800: Walt Whitman đã đăng tải ẩn danh những lời khen ngợi hết lời dành cho tác phẩm Leaves of Grass của chính mình . Về cơ bản, đó là phiên bản thế kỷ 19 của việc tạo một tài khoản ảo và tự chấm cho mình năm sao.
Đầu những năm 1900: Các tờ báo đã phải đối phó với thông tin bịa đặt, những tuyên bố phóng đại và những kẻ "làm giả". Đến năm 1913, tờ New York World đã thành lập Cục Chính xác và Công bằng, một phần để giải quyết các khiếu nại và "loại bỏ tin giả và những kẻ làm giả".
Trước thời kỳ quảng cáo trên internet: Các doanh nghiệp sử dụng lời chứng thực và sự tán thành như những công cụ tiếp thị, tạo ra vấn đề cơ bản mà chúng ta vẫn gặp phải ngày nay: Người này giới thiệu sản phẩm vì họ thực sự yêu thích nó hay vì có ai đó được hưởng lợi từ sự tán thành đó?
Internet thời kỳ đầu: Các diễn đàn trực tuyến, trang web đánh giá và sau này là thương mại điện tử cho phép các doanh nghiệp và cá nhân tạo tài khoản và đưa ra những lời khen ngợi—hoặc công kích đối thủ cạnh tranh.
Trớ trêu thay, chính Nirav lại là người đồng sáng lập Epinions vào năm 1999, một trong những nền tảng đánh giá do người dùng tạo ra đời sớm nhất. Giờ đây, ông thừa nhận rằng nền kinh tế đánh giá cuối cùng đã trở nên dễ bị thao túng.
Thập niên 2010: Việc tạo ra các đánh giá giả mạo trở thành một ngành công nghiệp. Các doanh nghiệp có thể mua các đánh giá tích cực, đối thủ cạnh tranh có thể bị tấn công bằng các đánh giá tiêu cực, và người đánh giá có thể sử dụng nhiều danh tính khác nhau.
Thập niên 2020: Các trang trại đánh giá ngày càng trở nên tinh vi. Các nhà điều tra phát hiện ra những người đánh giá phối hợp khen ngợi các doanh nghiệp không liên quan ở nhiều quốc gia, với những đánh giá giống hệt nhau đôi khi xuất hiện dưới những tên khác nhau.
Hiện nay: Trí tuệ nhân tạo tạo sinh (Generative AI) đã thay đổi đáng kể nền kinh tế. Thay vì trả tiền cho con người để viết hàng trăm bài đánh giá thủ công, ai đó có thể nhanh chóng tạo ra một lượng lớn văn bản thuyết phục. Nghiên cứu hiện nay cho thấy các hệ thống học máy (LLM) có thể tạo ra các bài đánh giá đánh lừa người đọc với khả năng ngang tầm con người, mặc dù các nhà nghiên cứu vẫn có thể xác định được một số khác biệt về ngôn ngữ bằng phương pháp thống kê.
Cùng một chiêu trò lừa đảo.
Máy móc tốt hơn nhiều.
Điều đó đưa tôi trở lại với Nextdoor
Hiện tại, Nextdoor đang đưa ra luận điểm rằng việc xác minh danh tính và trách nhiệm giải trình trong khu phố có thể làm cho các đề xuất trở nên đáng tin cậy hơn.
Đó là một chiến lược thú vị.
Nhưng chỉ riêng việc xác minh thôi thì chưa đủ để khẳng định một ý kiến là đúng sự thật.
Người thật cũng có thể phóng đại.
Một người đã được xác minh danh tính vẫn có thể có lòng thù hận.
Một người hàng xóm tốt bụng có thể giới thiệu công ty của bạn mình.
Khách hàng hợp lệ có thể nhận được ưu đãi.
Hai người hàng xóm đã được xác minh có thể có những trải nghiệm hoàn toàn khác nhau đối với cùng một doanh nghiệp.
Và, như tôi đã đề cập trước đây, tôi cũng có những thắc mắc riêng về độ tin cậy của hệ thống xác minh của Nextdoor.
Như vậy, "đã xác minh" là một tín hiệu đáng tin cậy.
Đây không phải là một loại thuốc thần kỳ giúp nói ra sự thật.
Nguồn gốc xuất xứ rất quan trọng? Tôi đồng ý.
Đó chính là điều làm cho bài đăng của Nirav trở nên thú vị.
Về cơ bản, luận điểm chính của ông ấy là:
Nguồn gốc thông tin rất quan trọng.
Tôi đồng ý.
Hoàn toàn.
Đó là lý do tại sao khi CEO nói:
“Một nghiên cứu năm 2025 đã phát hiện ra rằng…”
Tôi muốn biết nguồn gốc xuất xứ.
Hãy nêu tên nghiên cứu.
Hãy nêu tên các nhà nghiên cứu.
Liên kết đến nó.
Hãy để độc giả tự kiểm tra.
Và đó chính xác là điều tôi đã yêu cầu Nextdoor cung cấp liên quan đến nghiên cứu của chính họ.
Trong 86 ngày.
Nextdoor đã công bố kết quả khảo sát Insights.
Nextdoor đã công khai thông báo với người dùng rằng họ có thể yêu cầu dữ liệu chi tiết.
Tôi đã yêu cầu điều đó.
Tôi đã gửi email rồi.
Tôi đã liên hệ lại.
Tôi đã mở rộng phạm vi phân phối.
Tôi đã gửi một yêu cầu khác vào thứ Bảy.
Và tôi vẫn đang chờ đợi hai nghiên cứu chi tiết đó.
Ngày 86
Hôm qua là ngày Lễ Lao động.
Hôm nay tôi muốn hỏi:
Nextdoor đang gặp sự cố à?
Vì tôi vẫn đang làm việc.
Đang chờ ai đó ở Nextdoor trả lời các câu hỏi.
Bài đăng của Nirav lập luận rằng nguồn gốc xuất xứ rất quan trọng.
Chúng tôi đồng ý về điều đó.
Vậy đây là gợi ý của tôi cho Ngày 86:
Hãy luyện tập đi.
Khi trích dẫn nghiên cứu, hãy cho chúng tôi xem nghiên cứu đó.
Khi Nextdoor công bố nghiên cứu, hãy cho chúng tôi xem phương pháp nghiên cứu.
Khi blog của bạn thông báo cho độc giả rằng họ có thể yêu cầu dữ liệu chi tiết, hãy cung cấp dữ liệu chi tiết đó—hoặc giải thích lý do tại sao bạn không làm vậy.
Bởi vì dù chúng ta đang nói về bài đánh giá nhà hàng, đề xuất do AI tạo ra hay báo cáo phân tích doanh nghiệp, nguyên tắc vẫn như nhau:
Đừng chỉ bảo tôi tin tưởng. Hãy cung cấp cho tôi đủ thông tin để tôi tự quyết định có nên tin tưởng hay không.
Hãy theo dõi diễn biến tiếp theo của nghiên cứu trường hợp Nextdoor tại NielFlamm.com/blog.